一行代码不写,AI自己进化出夏普1.33的策略
一行代码不写,AI自己进化出夏普1.33的策略
前一天晚上,我给AI留了一句话:
你把这个趋势策略跑100轮进化,每轮试不同的参数和机制,目标是把夏普比率拉到最高。
然后我去睡了。
第二天早上打开电脑,110轮跑完,420次回测,最优的那一版夏普1.33,16年里只有一年亏钱,最大回撤9.1%。
策略的每一行代码都是它写的。我一个字都没动。
1. 为什么要做这件事
我帮客户代写过不少量化策略。有的是客户自己有想法,让我用代码实现;有的是看了别人的指标,让我改成可回测的版本。这些活儿干了几年下来,我慢慢意识到一件事。
AI只是在实现人的想法。
它代码写得再快、bug再少,最终策略是涨是跌,还是取决于交易员脑子里那个初始的念头。AI是手,人是脑。
那如果反过来呢?如果我不告诉它该怎么交易,只告诉它”想办法把这个策略做到最好”,让它自己去试,自己去错,自己去修正,会怎么样?
这就是这次实验想回答的问题。
2. 第一关:找不到合适的平台
说干就干,第一关就是该用什么平台。
国内的期货和股票平台大多是封闭的。它们的工作流程是:你在本地写好策略代码,复制粘贴到它们的编辑器里,点一下回测,等它跑完出结果。对一次性的策略验证来说够用,但对我想要的事情完全不行。
我要的是让AI不停地试,每试一版就立刻知道好坏,然后基于结果决定下一版怎么改。这种闭环要求策略代码、回测引擎、结果分析全部在同一个地方,AI能完整地读、完整地改。
封闭平台连入口都没有。
唯一一个能脚本运行的是tqsdk。 它提供Python API,可以在本地写脚本调用。但是它太慢了。一年的分钟数据,回测一次要几分钟。
听起来还行?算一下就明白了:100轮进化,每轮假如试4个变种,每变种要回测16年全量数据,那就是400次以上的全量回测。每次几分钟,整个流程跑下来几十个小时。一晚上根本跑不完。
vnpy的backtest模块也试过,速度类似,一样慢。
只有一个办法——自己写一个。
3. PowerQuant Backtest:用Rust重写一个回测引擎
我用Rust写了一个,叫 PowerQuant Backtest,已经开源在 Gitee,官网介绍见 powerquant.top/products/backtest。
为什么是Rust?Python的解释器本身就是瓶颈。vnpy那一整套事件驱动、指标计算、dispatch都在Python解释器里跑,再怎么优化也快不到哪去。要数量级的提升,只能换语言。
实际测下来,效果比预想的还好。我用RB88(螺纹钢连续主力)的1分钟K线做基准测试,数据跨度16年、123万根K线,对比了三套引擎:
| 框架 | 纯回测耗时 | 吞吐(bars/s) |
|---|---|---|
| PowerQuant Backtest(Rust原生策略) | 1.857秒 | 666,897 |
| PowerQuant Backtest(Python策略) | 7.989秒 | 154,982 |
| vnpy | 25.039秒 | 49,447 |
比vnpy快13.5倍。
123万根K线,1.8秒跑完。这意味着AI每试一版策略,几乎瞬间就能看到结果。100轮进化跑下来,光是回测环节也就几分钟。
还有一个关键问题:自己写的引擎,结果靠谱吗?会不会跑得快但算错了?
我对过,和vnpy的结果逐笔对齐:81,857笔闭合交易完全相同,最终权益差64元——在1000万的初始资金上,相对误差6.4×10⁻⁶,浮点累加的噪声级别。两种引擎在撮合语义上完全等价,只是速度快慢有别。
有了这个引擎,AI才真的具备了”自己进化”的物理条件。
4. 给AI一个指令,然后让它loop
剩下的工作,是写好那个指令。
现在Claude Code有一个 loop循环功能 ——你可以让它反复执行一个任务,每次自动基于上一次的结果决定下一步怎么走。这正好是我想要的。
我没给它具体的参数建议,也没告诉它该怎么改。我只说了几件事:
- 目标:把夏普比率拉到最高
- 约束:单次最大回撤不超过15%
- 数据:RB88的16年全量1分钟K线
- 自由度:参数、机制、过滤器,都可以试
- 规则:每轮试完写一份简短的总结,记录好的和坏的
然后我让它loop。
它确实干了一整晚。
5. 110轮进化的路径
第二天早上的日志很长。110轮迭代,420次回测,我把它整个过程梳理成了一张进化曲线:
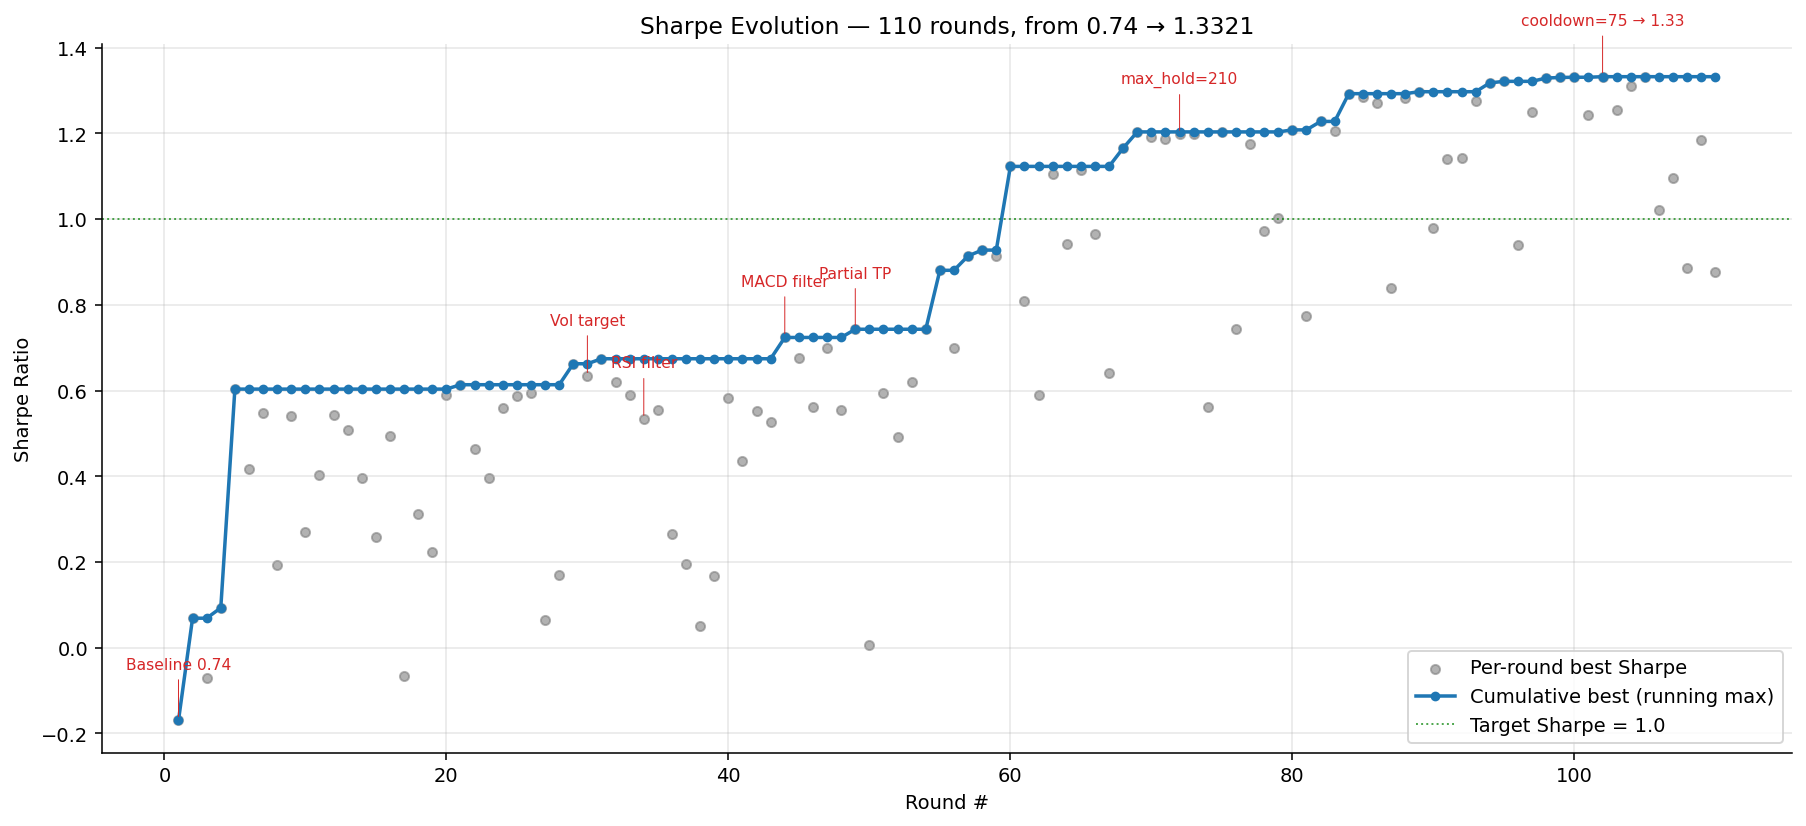
最上面的蓝线是累计最优夏普(每打破一次纪录就跳一格),灰点是每轮试出来的实际值。它不是一个单调上升的过程——有大量的失败、回退、重新尝试。
整体路径可以概括成六个阶段。
阶段一:从−0.17到0.66。
第一版策略夏普是负的,−0.17。原因很简单,我用的是1分钟K线,噪音太大,任何指标都被淹没。从1分钟重采样到60分钟是分水岭,这一步把夏普从负数拉到0.60。
AI自己摸索出了这一点。它试了几十个周期组合之后得出结论:1分钟周期对趋势策略是噪音,60分钟才是信号。
阶段二:过滤器探索,0.53到0.72。
AI试了RSI过滤、ADX强趋势过滤、波动率目标化,结果发现:过滤器不是越多越好。
RSI超买过滤让夏普掉0.10。ADX强趋势收紧让夏普掉0.07。只有顺势类过滤(MACD同向)有效,加了以后夏普第一次突破0.7。
这个结论反直觉。大多数人写策略的时候会本能地加各种过滤”提高胜率”,但AI用数据证明了:对趋势策略来说,任何”等待更多确认”的过滤都会错过入场点,损失大于避免的假突破。
阶段三:Partial TP是最大的单步提升。
第49轮,AI引入了”部分止盈”——当价格走到4.5倍ATR时,先平掉90%的仓位落袋为安,剩下的10%继续留着跑趋势。
这一步把夏普从0.74拉到0.88,胜率从38%跳到58%。
这是整个进化过程中最大的单步提升。道理也说得通:趋势策略最大的痛点是”利润回撤”,赚了50%又还回去30%。Partial TP解决的正是这个痛点——大头先落袋,小头继续赌。
阶段四到五:参数微调,1.12到1.33。
后面几十轮都是小步迭代:EMA周期从100调到162,ATR周期从5调到14,最大持仓时间调到210根K线,cooldown调到75根。每一步只涨0.02到0.05,但累计起来把夏普从1.12推到了1.33。
阶段六:确认收敛。
最后AI又跑了10轮”扰动实验”——故意把每个参数往旁边推一格,看会不会更好。结果全部失败:
- 把trail_mult从6.0收紧到5.0,夏普从1.33掉到0.89
- 加breakeven机制,掉到1.02
- 加金字塔加仓,收益涨但夏普掉到1.10
- 换成Donchian突破入场,掉到0.11
它自己得出结论:这个策略已经是局部最优,再往任何方向扰动都会降低夏普。
6. 最终的策略长什么样
R102(第102轮的最优版本)的关键参数:
| 参数 | 值 | 含义 |
|---|---|---|
| atr_period | 14 | ATR计算周期 |
| trail_mult | 6.0 | 趋势跟踪的止损倍数 |
| ema_period | 162 | 趋势判断的EMA周期 |
| macd_filter | 14/30/6 | MACD同向过滤 |
| partial_tp | 4.5×ATR / 90% | 部分止盈触发点和平仓比例 |
| risk_percent | 0.3% | 单次风险敞口 |
| max_hold_bars | 210 | 最大持仓时间 |
| cooldown_bars | 75 | 连亏后的冷却时间 |
16年的实测结果:
| 指标 | 值 |
|---|---|
| Sharpe | 1.3321 |
| Sortino | 1.9093 |
| Total Return | +244.80% |
| Max Drawdown | 9.10% |
| Win Rate | 64.38% |
| Profit Factor | 2.260 |
| 年正收益 | 16 / 17 |
| 最差年份 | −3.2%(2020) |
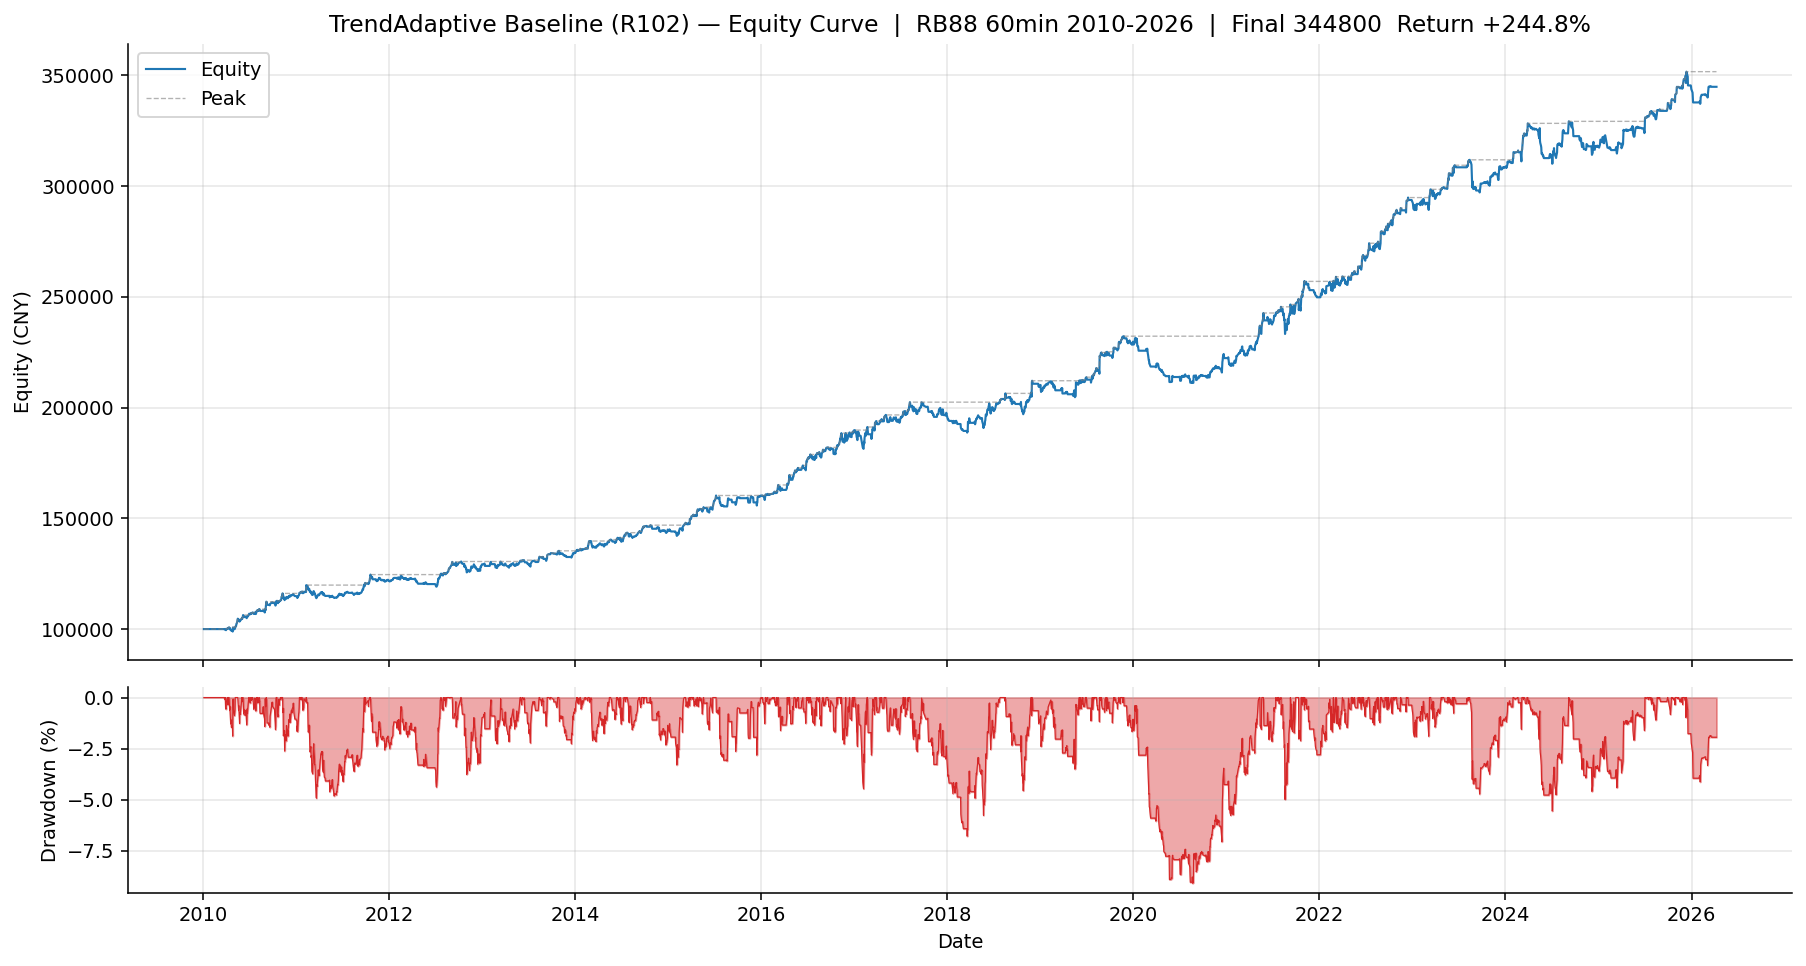
净值从10万涨到34.5万,16年单调上升。回撤阴影里可以看到,绝大多数时间回撤都在5%以内,最深那一次是9.10%。
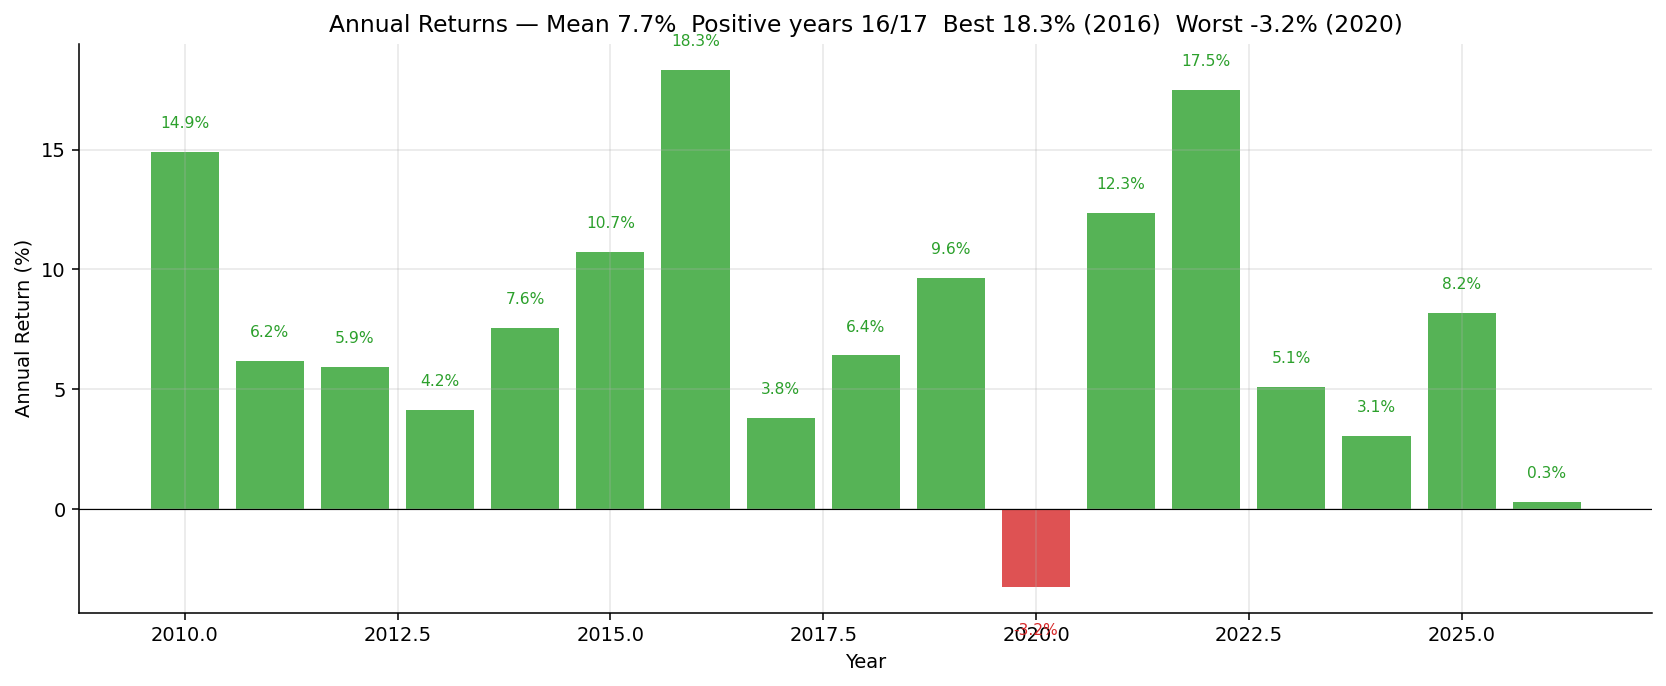
17个年份里只有2020年是亏的,亏了3.2%。其他16年全正,最好的2016年涨了18.3%。
再把粒度往下推一层,看月度:
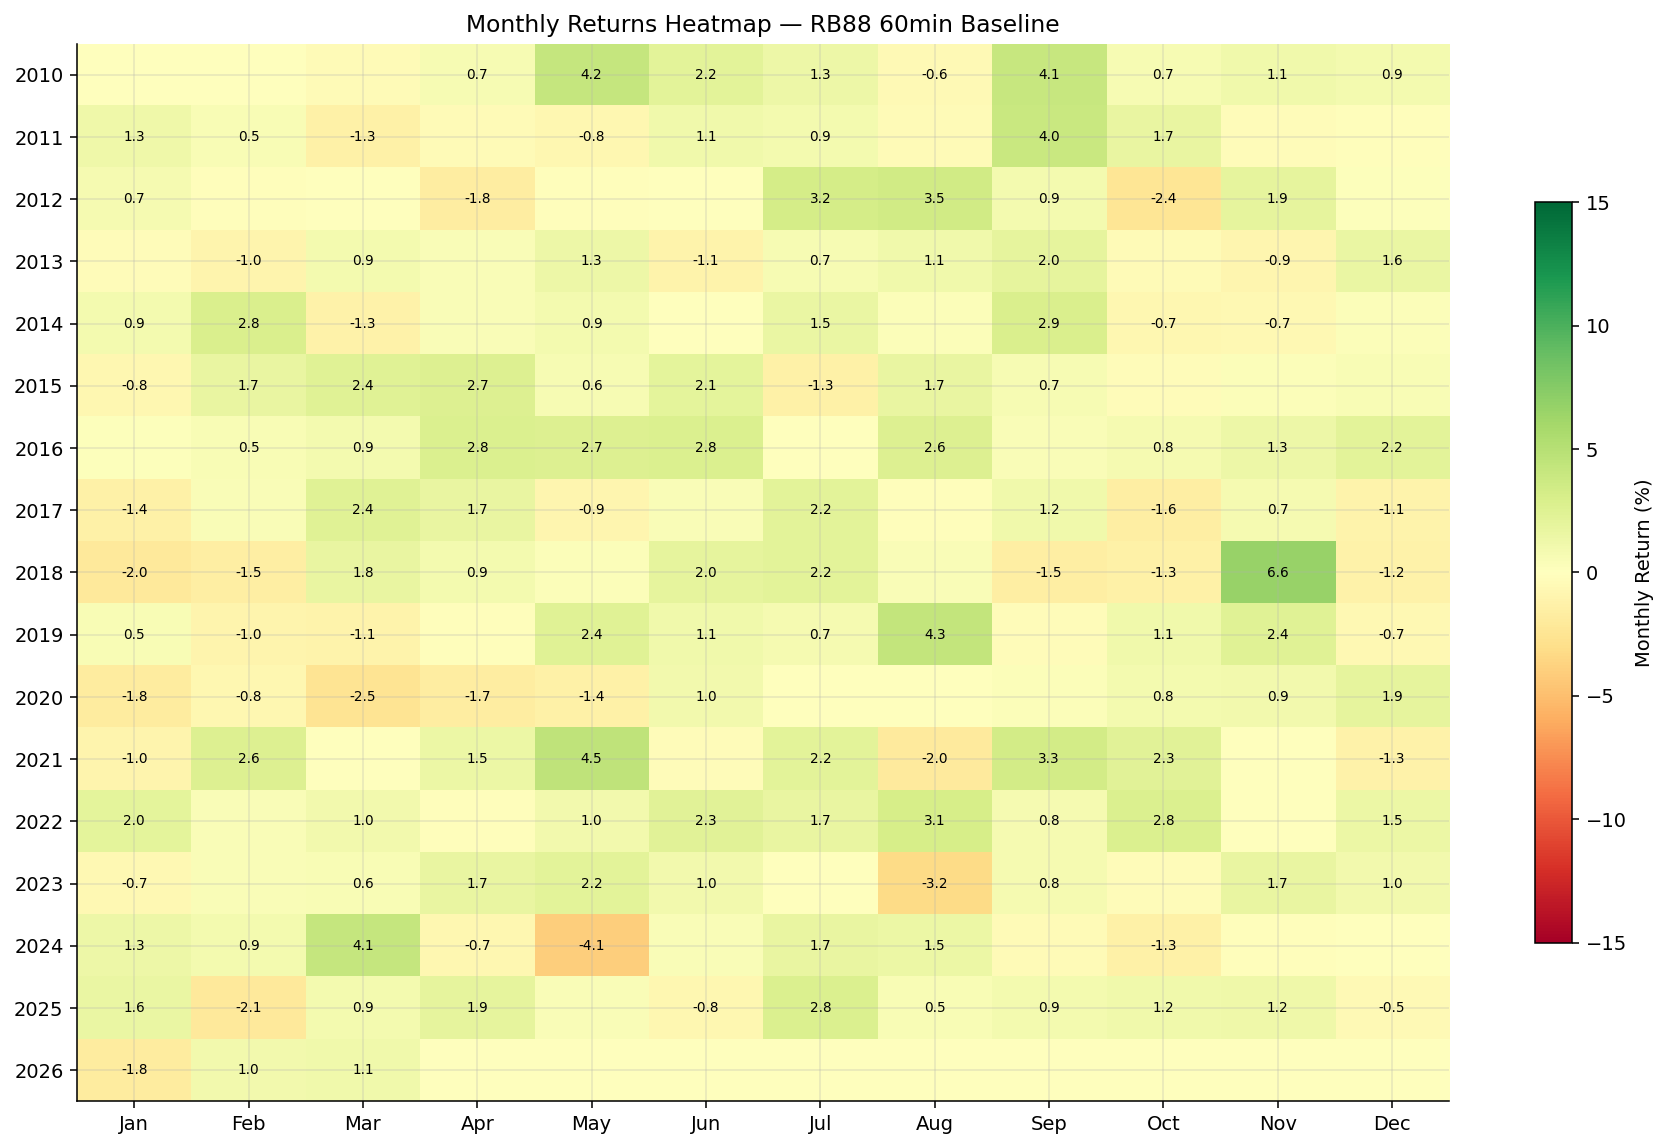
绿色为正、红色为负。整张图几乎被绿色铺满,红色零星分布且都集中在个别月份。没有出现明显的”某个月必亏”或”某个月必赚”的季节性规律——这是反过拟合的另一个证据,策略的盈利不依赖特定时间窗口。
最后看交易层面:
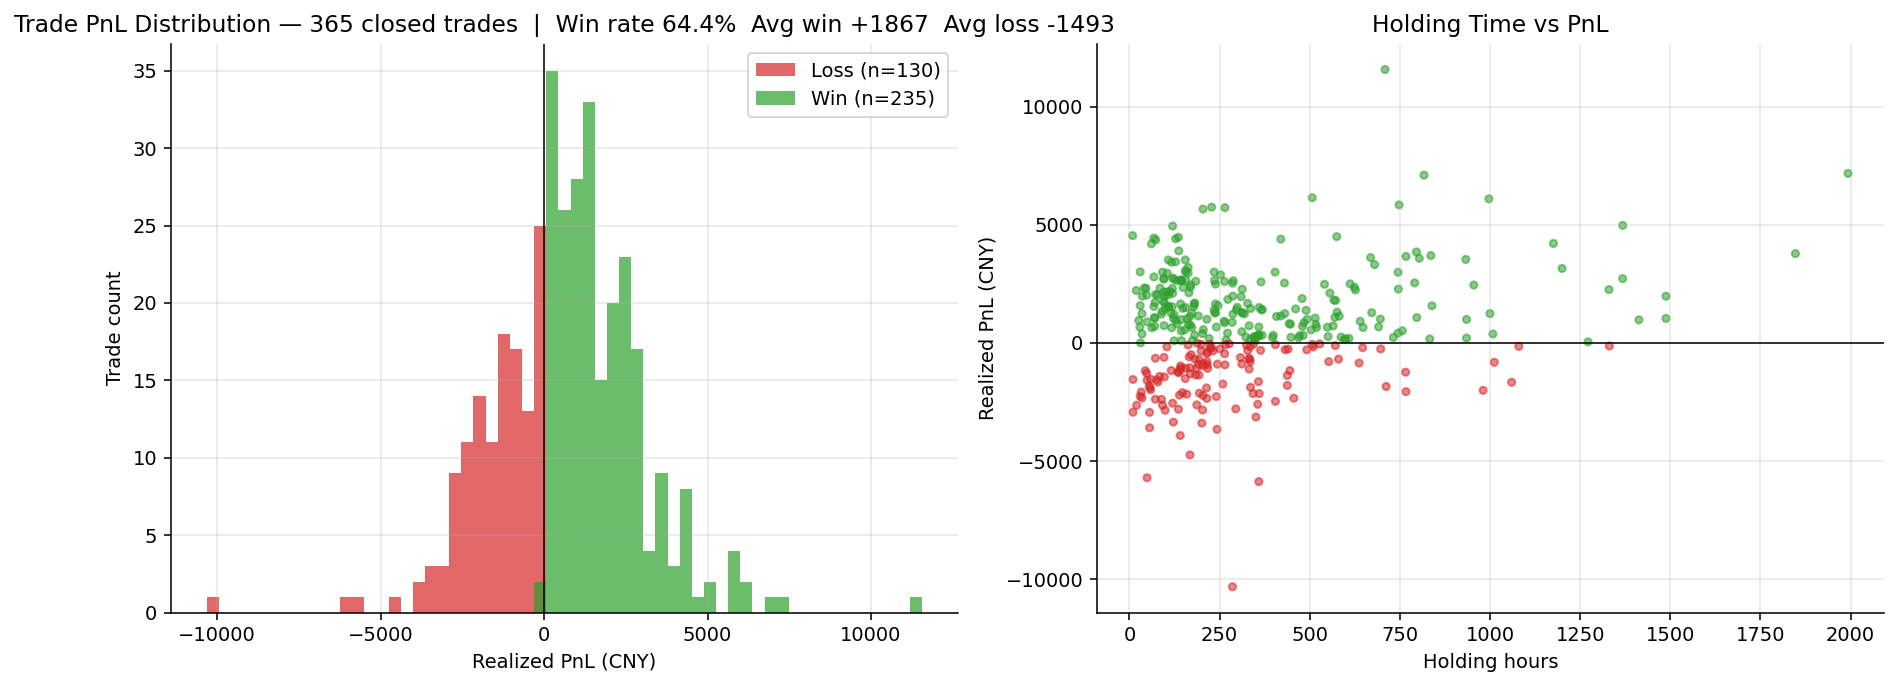
左图是盈亏直方图,分红绿。可以看出来,亏损一端(红)集中在小亏损区域,没有拖到右侧的长尾——这是trail_mult=6.0宽幅止损的体现,单次亏损被严格控制。盈利一端(绿)则有明显的长尾延伸,少数大赢交易贡献了相当比例的总收益。小亏多次、大赢少次的分布形态,正是趋势策略应该有的样子。
右图是持仓时长与盈亏的散点。能看出长期持仓的交易盈亏分布更宽——拿得住的单子,要么赚得多,要么也亏得多,但整体右侧(盈利侧)的厚度大于左侧。
7. 这不是针尖上的最优
过拟合是必须要回答的问题。100多轮试错,参数又是反复调出来的,会不会只是凑出了一组刚好适配历史数据的数字?
AI自己的扰动实验部分回答了这个问题——它在R102周围试了一圈变种,80%以上的配置夏普都还能维持在1.2以上。这个最优是平台型的,参数往左往右偏一点,策略依然有效。
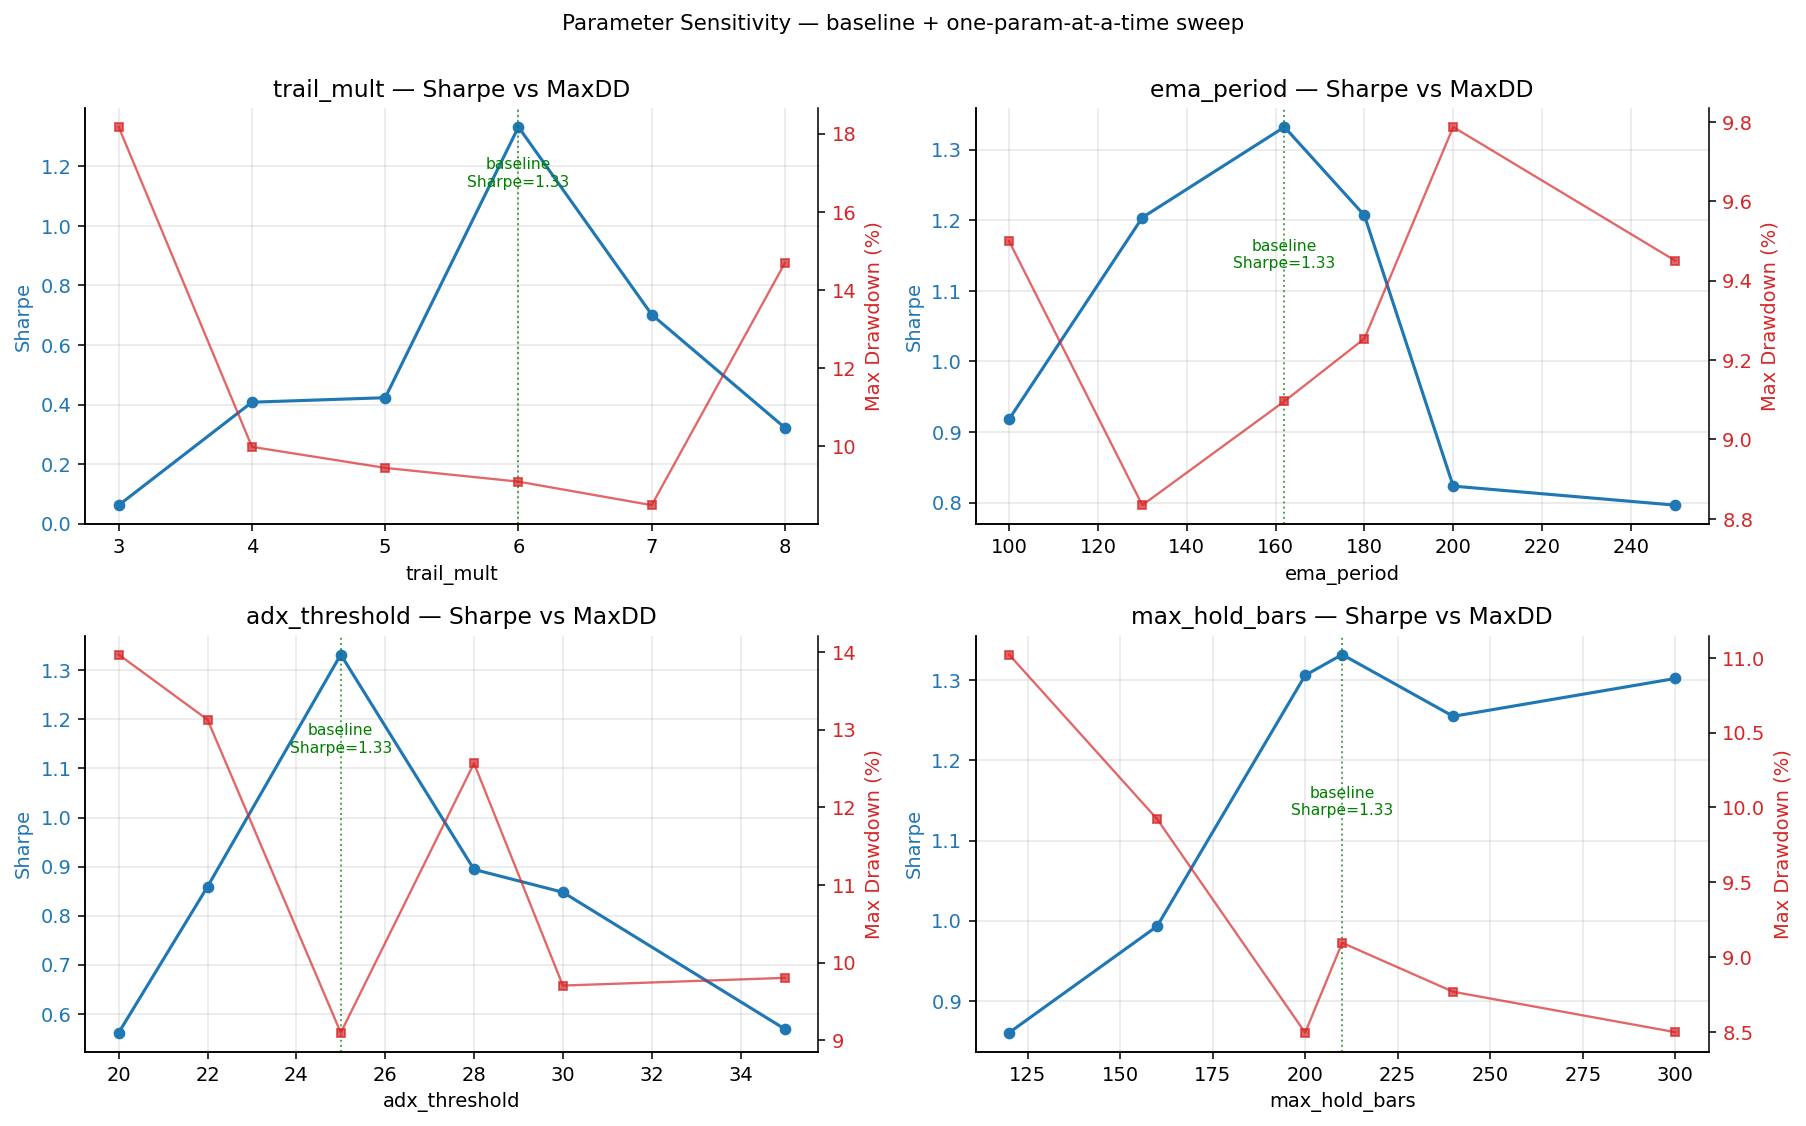
上面这张参数敏感性图把四个关键参数(trail_mult、ema_period、adx_threshold、max_hold_bars)各自扫描了6个值。蓝线是夏普,红线是最大回撤。可以看出来,每个参数在最优值附近都有一段平坦的高原,而非一座尖峰。这是反过拟合最强的证据之一。
更彻底的验证我会在后续文章里展开:Walk-Forward(前半段训练、后半段测试)、多品种验证(铁矿、焦炭等其他趋势品种)、Bootstrap置信区间。这些是必须要做的功课,但这不影响现在这个结论本身的意义。
8. 这次实验真正说明的事
这次实验里,AI做的事情已经超出了”实现人的想法”。
我没有告诉它该用60分钟周期。我没有告诉它要加Partial TP。我没有告诉它trail_mult必须是6.0。这些都是它自己试出来的,而且每一条都符合趋势策略的理论逻辑,有经济学解释,能说清为什么。
换句话说,AI在这里的角色,从”代码工人”变成了”研究合作者”。它负责大量的试错和模式识别,我负责给它目标、约束、和事后审查。
这是一种新的工作范式。
以前写一个策略,人的时间是主要瓶颈——想思路、写代码、调参数、跑回测、看结果、再改,一个循环下来半天就过去了。现在这个循环被压缩到秒级,人的时间从”执行”解放出来,留给”判断”。
判断什么?
判断AI试出来的东西是不是真有道理。判断某个”提升”是真信号还是数据噪音。判断这个策略能不能扛过未来没见过的市场。判断它找到的”局部最优”是不是我想要的”全局最优”。
这些事情,至少目前,还是人的工作。
这也让我重新想了想过去几年自己一直在做的事。我写过一篇叫《量化交易的工具陷阱》的文章,反思自己一直在造工具、不去做交易。那时候的结论是:别再造工具了,先把策略跑起来。
这次实验让我看到这个陷阱的另一面:当工具进化到足够强,策略本身可以让AI去跑。人真正要花时间的,是想清楚要让AI去跑什么。
指令的质量,决定了结果的质量。
我给它的那个指令,其实是我自己想了很久才想清楚的——目标、约束、自由度、规则,四个要素缺一不可。指令模糊一点,AI就会在错误的方向上狂奔一百轮,最后拿回来一个看起来不错但没有逻辑的过拟合策略。
这大概是这次实验对我最大的提醒:AI变强了,人却没有因此变轻松——真正变值钱的,是判断力。
那么问题来了:当AI可以从−0.17一路进化到1.33,下一步它还会进化到哪?
如果你的竞争对手已经开始这样工作,你还在手写每一行代码吗?
参考资料
- 策略源码与进化日志:TrendAdaptive策略,110轮迭代完整记录
- 基准测试数据:RB88螺纹钢连续主力,1分钟K线,2010-2026,123万根
- 回测引擎:PowerQuant Backtest 官网介绍 | Gitee 源码(Rust实现,已开源)
- 进化方法:基于Claude Code的loop循环功能,单次指令自主迭代
- 策略指标:Sharpe 1.3321,Sortino 1.9093,年化收益7.70%,最大回撤9.10%,16/17年正收益